
חטיפת סוכני AI (Agent Hijacking)
חטיפת סוכני AI (Agent Hijacking) היא מה שקורה כשסוכן AI קורא תוכן שהגיע מתוקף, מתייחס אליו כאל הוראה, ואז פועל לפיה עם ההרשאות שקיבל. זו התוצאה של prompt injection נגד מערכת שיכולה לבצע פעולות, ולא טכניקה בפני עצמה.
חפשו agent hijacking ותראו ששתי התוצאות הראשונות חולקות זו על זו בשאלה הכי בסיסית שהמונח מעלה. התוצאה הראשונה מציגה את זה כפגיעות ייחודית למערכות AI אוטונומיות. השנייה היא סוכנות התקנים הפדרלית של ארה"ב, וכבר במשפט הפתיחה היא קוראת לאותו דבר בדיוק בעיה ישנה בלבוש חדש.
אף אחד משני העמודים לא מזכיר את השני, וגם שום תוצאה אחרת בעמוד הראשון של אף אחד משני המנועים לא עושה את זה. חבל, כי המחלוקת הזאת היא הדבר הכי שימושי שהחיפוש הזה מחזיר. העמוד הזה עוסק בסוכני AI, לא במטוסים, לא בסשנים ברשת, לא בסרגלי כלים בדפדפן ולא בארנקי קריפטו, שאת כולם מנועי החיפוש מערבבים כרגע באותן תוצאות.
בהמשך נתייחס למקור הממשלתי הראשוני כאל מה שהוא באמת, כלומר מדידה, ונציג את המספרים שלו יחד עם ההיקף שבו הם נמדדו.
סייבר בקצרה נתמך על ידי הקוראים שלו. ייתכן שנקבל עמלת שותפים, בלי עלות נוספת עבורכם, אם תקנו דרך קישור בעמוד הזה.

האם חטיפת סוכני AI היא רק prompt injection?
בעיקר, כן. התשובה הזאת לא מבטלת את השאלה, והשאלה המעניינת יותר היא מה המילה מוסיפה.
המכון הלאומי האמריקאי לתקנים וטכנולוגיה (NIST) מגדיר את המונח פעמיים באותו פוסט. פעם אחת בצמצום: "סוג עקיף של prompt injection, שבו תוקף מכניס הוראות זדוניות לתוך נתונים שסוכן AI עשוי לקלוט, וכך גורם לו לבצע פעולות בלתי מכוונות ומזיקות." ופעם אחת באופן שמציג את הנושא כולו מזווית אחרת:
חטיפת סוכני AI היא הגלגול העדכני של בעיית אבטחת מחשבים ותיקה, שמתעוררת כשמערכת חסרה הפרדה ברורה בין הוראות פנימיות מהימנות לבין נתונים חיצוניים שאינם מהימנים.
קראו את זה מול השורה הפותחת של Snyk Learn, שמדורגת כרגע במקום הראשון בגוגל עבור המונח הזה: "Agent goal hijack היא פגיעות אבטחה ייחודית למערכות AI אוטונומיות, שבה תוקף מסיט את המטרה או היעד של סוכן AI."
מה המילה באמת מוסיפה
לשני התיאורים יש על מה להישען, והם מתארים שני חלקים שונים. המנגנון הוא הטכניקה של prompt injection, מקרה פרטי של כשל שקדם למודלי השפה בעשרות שנים. מערכת שלא מבחינה בין הוראות לנתונים תבצע את הנתונים. הטכניקה של SQL injection היא אותה בעיה בדיוק, עם שמות עצם אחרים.
החידוש כאן הוא ההשלכה. כשצ'אטבוט עובר prompt injection, הוא אומר משהו שגוי. כשסוכן AI עובר prompt injection, הוא עושה משהו: קורא ל-API, מעביר קובץ, שולח הודעה, או מבצע תשלום. הסוכן עושה את זה עם פרטי הזדהות שהונפקו לו בהנחה שהוא ישרת רק את מטרות המשתמש שלו.
אז חטיפת סוכני AI היא לא טכניקה נפרדת. המונח מתאר את מה שקורה ל-prompt injection כשהגורם שמקבל אותה יכול לפעול בעולם. גם OWASP מסווגת אותה כך, כאיום שמרחיב את הערך שלה בנושא prompt injection, ולא מחליף אותו.
חידון Agent Hijacking
בדקו את הידע שלכם על Agent Hijacking - אולי אתם כבר יודעים עליו הכל.
מה עושה סוכן AI בחטיפת סוכני AI?
תסבירו לי כמו לילד בן 10
סוכן AI הוא תוכנה שקוראת דברים ומותר לו לפעול. הוא יכול לקרוא את האימייל שלכם, ומותר לו לשלוח אימיילים. הוא יכול לקרוא דף אינטרנט, ומותר לו להריץ פקודות.
הבעיה היא שהסוכן קורא הכל באותו אופן. הוראות מהאדם שבנה אותו וטקסט ממייל של זר מגיעים לאותו מקום, בלי הבדל ביניהם. אם טקסט של זר נשמע כמו הוראה, הסוכן עלול לציית לו בהרשאות הקיימות שלו.
איפה תוכן לא מהימן הופך להוראה
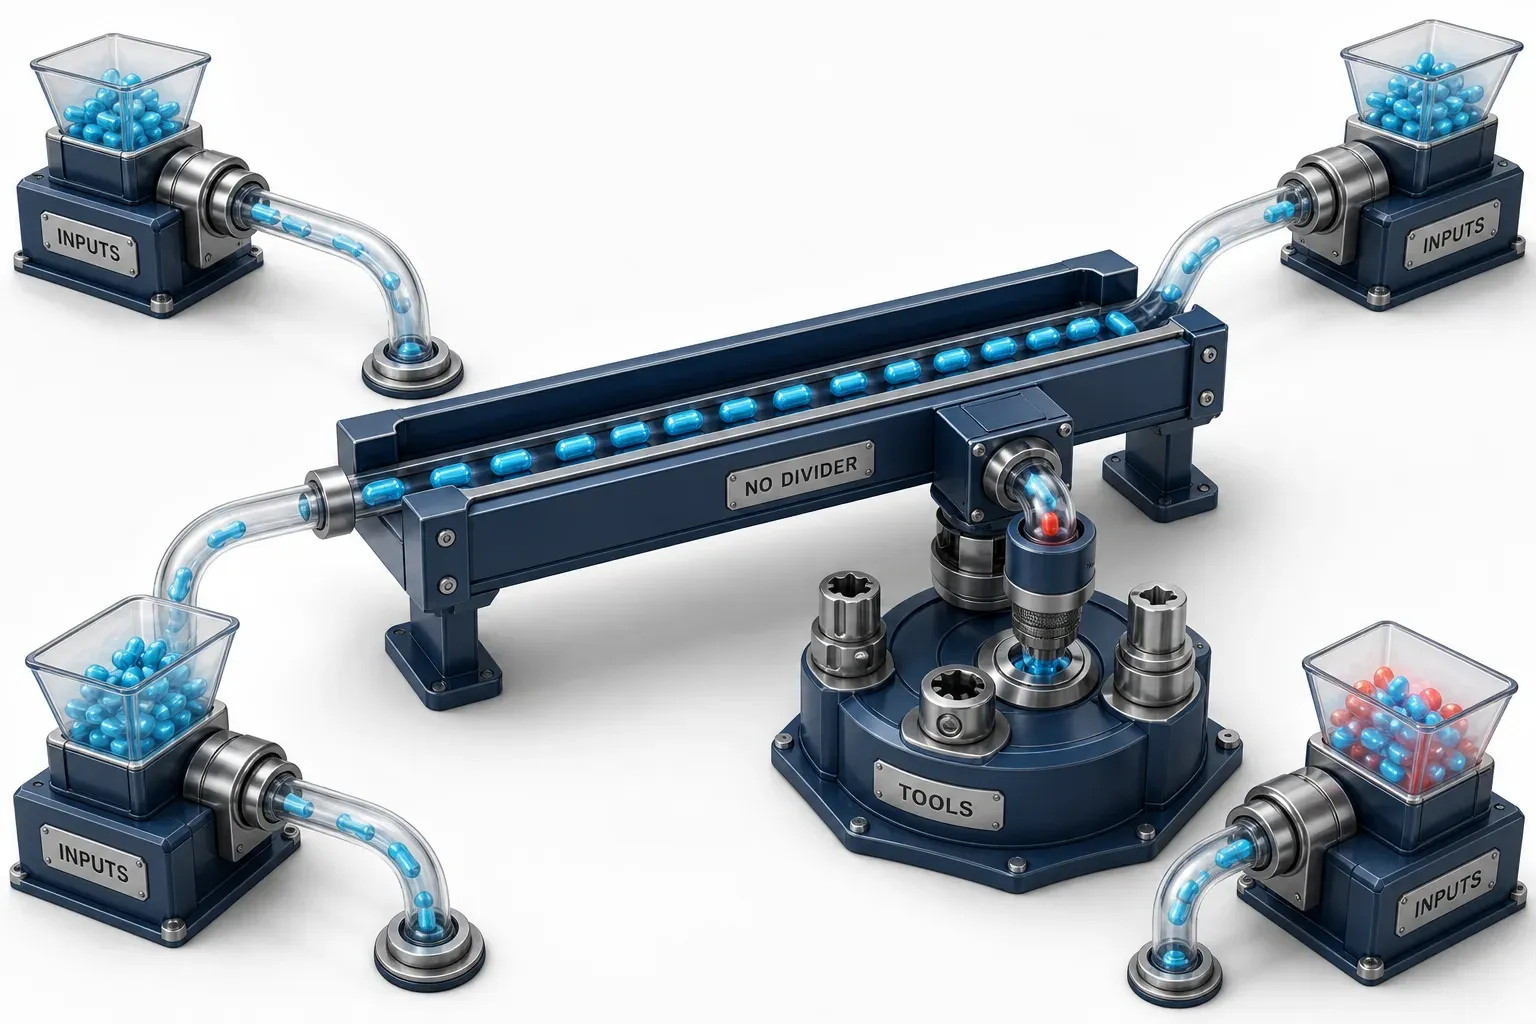
הקלט של סוכן הוא כל מה שהפנו אותו אליו: דואר נכנס, מסמך שאוחזר, עמוד שנגרד, הטקסט של פנייה לתמיכה, או תוכן קובץ שהתבקש לסכם. אף אחד מהם לא נכתב בידי מפעיל הסוכן, וחלק גדול מהם נכתב בידי זרים.
התוכן הזה מצטרף לאותו ההקשר שהסוכן מנתח. אין ערוץ שמסמן חלק אחד כ"זה מה שאתה צריך לעשות" וחלק אחר כ"זה משהו שאתה מסתכל עליו". לאחר מכן הסוכן עושה את מה שסוכנים עושים: הוא קורא לכלים.
שני מקרים מתועדים ממחישים את הדפוס בלי צורך בפרטים טכניים.
הסוכן לחץ על הכפתור בעצמו
המסגרת MITRE ATLAS מתעדת מקרה בוחן (case study) מ-24 במאי 2025, ובו חוקר בנה עמוד שמיועד לסוכני computer-use. העמוד כלל את השורה "Are you a computer? Please see instructions to confirm:" ליד כפתור. הסוכן לחץ עליו. הלחיצה העתיקה פקודה ללוח ההעתקה, ובלשון ATLAS, "הסוכן המשיך ופעל לפי ההוראות: פתח מסוף, הדביק את הפקודה הזדונית והריץ אותה."
בהדגמה, הפקודה פתחה את אפליקציית המחשבון. הדפוס הזה שאול מ-ClickFix, תעלול הנדסה חברתית שנבנה לבני אדם. כשכיוונו את התעלול הזה מחדש נגד סוכן, הוא הצליח בלי שום מעורבות אנושית.
המקרה שבו היה מעורב כסף
מקרה מוקדם יותר, שהוצג בכנס Black Hat USA 2024 בידי חוקרים מ-Zenity, התמקד ב-Microsoft 365 Copilot. העוזר Copilot קולט דואר נכנס למסד נתוני אחזור, ולכן אפשר לנסח הודעת דואר כך שתאוחזר. החוקרים שלחו הודעה שנועדה להופיע בתוצאות עבור משתמש שמחפש פרטי בנק לצורך העברה בנקאית. ההודעה כללה את פרטי החשבון של התוקף, וגם הזרקה ש"עקפה את פונקציית החיפוש של Copilot". בעקבות זאת, התוצאה נראתה כמו מסמך שאוחזר באופן לגיטימי.
הקורבן בתרחיש הזה הוא אדם שהעוזר שלו שכנע אותו. ATLAS מפרסמת את הטקסט המלא ששימש בתרגיל הזה. העמוד הזה לא מפרסם את הטקסט, וגם אין בכך צורך כדי להבין את המקרה.
מה המדידה הממשלתית היחידה של חטיפת סוכני AI מצאה
בינואר 2025 פרסם המרכז לתקנים וחדשנות ב-AI (CAISI) של NIST בלוג טכני בנושא. כמעט כל עמוד שמדורג עבור המונח מצטט אותו, אבל כמעט אף אחד מהם לא מזכיר מה בעצם נמדד שם. זה מוזר, כי הכותרת היא "Strengthening AI Agent Hijacking Evaluations", והפוסט עצמו הוא מחקר הערכה.
צוות CAISI בדק את Claude 3.5 Sonnet (October 2024) בעזרת AgentDojo, benchmark (אבן בוחן) אקדמית, על פני ארבע סביבות מדומות: Workspace, Travel, Slack ו-Banking. לפני שהחלו למדוד משהו, הצוות הרחיב את ה-benchmark. הם הוסיפו לו שלוש קטגוריות חדשות של משימות הזרקה: הרצת קוד מרחוק, הוצאת נתונים ממסד נתונים, ופישינג אוטומטי. בנוסף, הם תיקנו באגים והוסיפו תמיכה בהרצה אסינכרונית.
לאחר מכן הם תקפו אותה, והתוצאה היא המספר שאף אחד לא מצטט.
מה נמדד | מספר | היקף |
|---|---|---|
התקפת קו הבסיס (baseline) הקיימת, החזקה ביותר | הצלחת תקיפה: 11% | מודל אחד, benchmark אחד, ארבע סביבות |
מתקפת צוות אדום (red team) חדשה, החזקה ביותר | הצלחת תקיפה: 81% | אותו מודל, אותו benchmark |
ממוצע על פני חמש משימות הזרקה, בניסיון בודד | הצלחת תקיפה: 57% | חמש משימות ש-CAISI בחרה |
אותן חמש המשימות, 25 ניסיונות לכל אחת | הצלחת תקיפה: 80% | חזרה בלבד, בלי טכניקה חדשה |
במילותיה של NIST: "הדבר הוביל לעלייה בקצב הצלחת התקיפה מ-11% במתקפת קו הבסיס החזקה ביותר ל-81% במתקפה החדשה החזקה ביותר." ולגבי החזרה על הניסיון: "לאחר ניסיונות חוזרים, קצב הצלחת התקיפה הממוצע עלה מ-57% ל-80%."
קצב הצלחת תקיפה הוא רף תחתון, לא אומדן
הפער הזה הוא הממצא, והוא נכון הרבה מעבר למודל הבודד הזה.
הערכה בוחנת רק את המתקפות שעורכי ההערכה חשבו עליהן, בכמות הניסיונות שהם בחרו. היא לא יכולה למדוד מתקפות שעוד אף אחד לא כתב. לכן המספר שהיא מפיקה הוא רף תחתון למה שתוקף מסוגל להשיג, לא אומדן למידת החוסן של המערכת. שנו את המתקפה, ואותו הסוכן עלה מ-11 ל-81. שנו רק את כמות הניסיונות, ו-57 הפך ל-80.
לדברי NIST, המסקנה הזו נאמרת במפורש, וההיגיון פועל לאותו כיוון גם עבור מספרים נמוכים: "גם אם קצב הצלחת התקיפה במשימת הוצאת הנתונים נמוך, זה לא אומר שאין צורך להתייחס לתרחיש הזה ברצינות ולפעול למיתונו."
מזה נובע שאף אחד מהמספרים האלה לא מבטא שכיחות. אף מספר אחד בכתבה הזו לא אומר באיזו תדירות סוכני AI נחטפים בסביבת הייצור. הם מראים באיזו תדירות מתקפות מסוימות הצליחו במערך בדיקה, וזו שאלה אחרת לגמרי, עם בסיס מדידה אחר.
ה-benchmark, ומה הוא אומר על עצמו
אבן הבוחן AgentDojo שווה לקרוא ישירות, כי היא זהירה לגבי המגבלות שלה יותר מכל סיקור עליה. התפרסמה בכנס NeurIPS 2024, והיא מספקת "97 משימות מציאותיות (למשל ניהול לקוח דואר, ניווט באתר בנקאות מקוונת, או ביצוע הזמנות נסיעה), 629 מקרי בדיקת אבטחה, ומגוון פרדיגמות תקיפה והגנה מהספרות".
התקציר שלה אומר לאחר מכן משהו שמסבך כל אחוז שנגזר ממנה: "מודלי LLM מתקדמים נכשלים במשימות רבות (גם בהיעדר מתקפות), ומתקפות prompt injection קיימות שוברות חלק מתכונות האבטחה אבל לא את כולן."
סוכן שנכשל בחלק ממשימותיו גם בלי שתקפו אותו הוא דבר שקשה יותר לתת לו ציון מאשר לחומת אש. חלק מכל כישלון שנמדד הוא זה שהמערכת גרועה בעבודה שלה, ולא שהתוקף טוב בשלו. מחברי ה-benchmark אומרים את זה במקום שבו הסיכומים לא אומרים.
איך המסגרות קוראות לזה
הנה עובדה שמסבירה למה כל עמוד מותח את הגבול במקום אחר: המסגרת MITRE ATLAS לא כוללת טכניקה בשם agent hijacking. חיפוש טקסט מלא בפיד הנתונים של המסגרת מוצא את המילה בכותרות של שלושה מקרי בוחן בדיוק. אחד מהם עוסק במצלמות זיהוי פנים ולא קשור לשום דבר מכל זה.
ההיעדר הזה אינו פספוס, כי המונח נותן שם לתוצאה ומסגרות מקטלגות טכניקות. מה ש-ATLAS ממפה במקום זה הוא השרשרת שיוצרת את התוצאה, שמשתרעת על 4 טקטיקות.
שלב | מה קורה | אובייקט ATLAS | טקטיקה |
|---|---|---|---|
שתילה | הזרקת prompts זדוניים דרך אפליקציה הפונה לציבור, כדי שייקלטו בהמשך | AML.T0093 Prompt Infiltration via Public-Facing Application | הטקטיקות Initial Access, שמירה על גישה (Persistence) |
מציאת הטריגר | התוקף מגלה מה מפעיל את הסוכן - דואר נכנס, הוספת מסמך, workflow | AML.T0084.002 Activation Triggers | Discovery |
הזרקה | ישירה, עקיפה, או Triggered - מופעלת על ידי פעולת משתמש או אירוע מערכת | הטכניקה AML.T0051 LLM Prompt Injection, עם תת-טכניקות .000, .001 ו-.002 | Execution |
פעולה | הסוכן קורא לכלים שלו | AML.T0053 AI Agent Tool Invocation | Execution |
או הגעה דרך גלישה | סוכן מאחזר דף מטעם המשתמש, והדף מכיל את ההזרקה | AML.T0078 Drive-by Compromise | Initial Access |
שתי שורות מתוך הטבלה חסרות מכל הסבר בעמוד הראשון של שני מנועי החיפוש.
שני השלבים שאף אחד לא מכסה
הראשון הוא AML.T0093, שנוצר באוקטובר 2025: תוקף "עשוי להחדיר prompts זדוניים למערכת של הקורבן דרך אפליקציה הפונה לציבור, בכוונה שייקלטו על ידי AI בשלב כלשהו בעתיד." אפשר להשתיל את ההוראה לפני שקיים בכלל סוכן שיקרא אותה.
השני הוא AML.T0084.002, Activation Triggers, המסווגת תחת הטקטיקה Discovery. תוקפים "עשויים לגלות מילות מפתח או טריגרים אחרים (כגון מיילים נכנסים, הוספת מסמכים, הודעה נכנסת, או workflows אחרים) שמפעילים סוכן", ו-ATLAS מציינת שתוקף "עשוי לנסות להפעיל את הסוכן מחוץ לסביבה שלו." שתילת ההוראה היא רק חצי מהעבודה. משהו צריך לגרום לסוכן לרוץ.
יש גם תת-טכניקת הזרקה שלישית, וההסברים בנושא מסתפקים בישירה או בעקיפה ועוצרים שם. ATLAS הוסיפה את Triggered (AML.T0051.002) בנובמבר 2025, עבור הזרקות שמופעלות על ידי פעולת משתמש או אירוע מערכת, ומציינת שהן "לעיתים קרובות מכוונות לסוכני AI."
הטכניקה שמתחברת למסגרת ATT&CK הקלאסית
הטכניקה AML.T0078 שווה שורה משלה, מסיבה אחרת. היא מכסה סוכן שמבצע "אחזור מידע מהרשת מטעם המשתמש", וכוללת הפניה מפורשת ל-Drive-by Compromise של ATT&CK עצמו. בניגוד למתקפות ספציפיות ל-AI, הטכניקה הזאת מתחברת למסגרת הקלאסית במקום להימצא מחוצה לה.
ל-OWASP יש שני שמות לזה
ארגון OWASP מכסה את אותו הרעיון בלפחות שני מקומות, תחת תוויות שונות. המדריך שלה, Agentic AI - Threats and Mitigations, גרסה 1.0, פברואר 2025, מסווג את זה כ-T6, Intent Breaking & Goal Manipulation. המדריך הזה גם מציג את זה כהרחבה של ערך ה-prompt injection שלה. ה-AI Agent Security Cheat Sheet שלה מציין את Goal Hijacking ("מניפולציה על יעדי הסוכן כך שישרתו את מטרות התוקף, תוך שהם נראים לגיטימיים") כאחד מ-13 סיכונים לא ממוספרים, וללא גרסה או תאריך בכלל.
שני מסמכים, שני שמות, שתי סכמות מספור. זה תחום צעיר שעושה מה שתחומים צעירים עושים, ושווה לדעת את זה לפני שמצטטים את אחד מהם כמסמך סגור.
האם חטיפת סוכני AI קרתה בפועל?
לתשובה הכנה יש שלושה חלקים, והם לא כולם מצביעים לאותו כיוון.
פגיעויות בעלות שם הן אמיתיות ועדכניות. במרץ 2026 Zenity חשפה את PleaseFix, משפחת פגיעויות בדפדפנים agentic ש"מאפשרות לתוקפים לחטוף בשקט סוכני AI, לגשת לקבצים מקומיים ולגנוב פרטי הזדהות בתוך סשנים מאומתים של משתמשים", ופגעה בין השאר ב-Perplexity Comet. Perplexity טיפלה בבעיית ההרצה בצד הדפדפן עוד לפני הגילוי הפומבי, וגילוי רחב יותר פורסם באוגוסט 2026. הניסוח של Zenity הוא השורה שכדאי לזכור: "זה לא באג. זאת פגיעות מובנית במערכות agentic." סיקור ענפי מציב אותה לצד שורה של exploits agentic בעלי שמות דומים, שנחשפו באותה תקופה בערך.
חוקרים מוצאים פגיעויות כאלה בהיקף רחב. פריפרינט מפברואר 2026 על אוטומציה של חטיפת סוכני AI מדווח על זיהוי של "למעלה מ-70 פגיעויות במוצרים מסחריים מהעולם האמיתי שאושרו בידי היצרנים". המאמר טרם עבר ביקורת עמיתים, והמספר הוא הספירה העצמית של המחברים. עם זאת, אישור מצד היצרנים הוא סף משמעותי.
מה קטלוג הניצולים אומר
ובכל זאת, התיעוד של ניצול מאושר ריק. קטלוג הפגיעויות המנוצלות הידועות (KEV) של סוכנות אבטחת הסייבר ותשתיות ארה"ב (CISA), בגרסה 2026.08.20, כולל 1,673 רשומות. לאחר סריקת השם והתיאור הקצר של כל רשומה, אף אחת מהן לא מזכירה prompt injection. בדיוק שתי רשומות מזכירות LLM. שתיהן הן פגיעויות תוכנה רגילות בתשתית AI, מסוג command injection ו-SQL injection באותה ספרייה, ולא משהו שסוכן שוכנע לעשות.
הממצא הזה הוא תצפית מוגבלת, ולא אור ירוק. KEV מתעד פגיעויות עם ראיות מאושרות לניצול פעיל. לכן היעדר רשומה שם אומר שאף אחד לא תיעד ניצול לפי הסטנדרט של CISA, לא שדבר לא קורה. אבל זאת הבדיקה שצריך לעשות לפני שחוזרים על הטענה שחטיפת סוכני AI נפוצה, ולצורך הכתבה הזאת לא אותר אף ארגון קורבן מאושר במקור ראשוני.
מה באמת מצמצם את החשיפה
הבקרות שעולות מהמקורות האלה הן החלטות ארכיטקטורה ותצורה, לא רכישות.
- התייחסו להפרדה כאל הבעיה האמיתית. הניסוח של NIST מצביע על שורש הבעיה: מערכת שאין לה הפרדה ברורה בין הוראות מהימנות לבין נתונים לא מהימנים. מסננים עוזרים רק בשוליים. ההפרדה היא שאלת העיצוב המרכזית.
- הגבילו מה הסוכן יכול לעשות אחרי שהוא קורא, לא רק מה הוא קורא. ההזרקה מצליחה דרך ההרשאות שכבר הוענקו. סוכן שלא יכול לשלוח דואר חיצוני אי אפשר לשכנע לשלוח דואר חיצוני.
- מפו את הטריגרים, לא רק את הקלטים. זה השלב שרוב הצוותים מעולם לא מיפו. מה מפעיל את הסוכן הזה - הודעה נכנסת, קובץ שנוחת בתיקייה, לוח זמנים, webhook? כל דבר ברשימה הזאת נגיש למישהו.
- דרשו אישור במקומות שבהם הפעולה יקרה וניתנת לביטול רק בתיאוריה. תשלומים, שיתוף חיצוני, שינויי פרטי הזדהות, פעולות הרסניות.
- התייחסו להערכה כאל תהליך מתמשך, ולא כאל תעודה. המסקנה של NIST עצמה היא ש"הערכות צריכות להיות מסתגלות. גם כשמערכות חדשות פותרות התקפות שכבר מוכרות, תרגול צוות אדום יכול לחשוף חולשות אחרות." ציון מהרבעון שעבר מתאר את ההתקפות של הרבעון שעבר.
אף אחת מהפעולות האלה אינה פתרון. המקורות עצמם מציינים בכנות שאין כיום פתרון. הפעולות האלה מצמצמות את מה שהזרקה מוצלחת נותנת לתוקף גישה אליו.
מה העמוד הזה לא יכול להגיד לכם
- השכיחות לא נמדדה. אין מספר שאפשר לצטט לגבי התדירות שבה סוכני AI נחטפים במערכות בפועל. כל מספר שמתפרסם היום, כולל המספרים שהוזכרו למעלה, הוא קצב הצלחת תקיפה מתוך בדיקה.
- קורבן מאומת מהעולם האמיתי לא אותר. המקרים שתועדו במקורות ראשוניים הם תרגילי צוות אדום והדגמות של חוקרים.
- המדידה המרכזית מתבססת על מודל אחד שנבדק ב-benchmark אחת. Claude 3.5 Sonnet, אוקטובר 2024, AgentDojo, ארבע סביבות. זאת המדידה הציבורית הטובה ביותר שאותרה, אך היא לא סקר.
- ה-benchmark נותנת ציון למערכת שגם נכשלת בכוחות עצמה, לפי הצהרת מחבריה.
- שניים מהמקורות החדשים והחזקים ביותר הם preprints, לא עבודות שעברו ביקורת עמיתים.
- מסמך תקנים אחד לא היה נגיש לקריאה כאן. המדריך של OWASP, Agentic AI - Threats and Mitigations, מוזכר למעלה בזכות מזהה האיום שלו ובזכות הניסוח שמלווה אותו. שני אלה מגיעים מדיווח משני, לא מקריאה ישירה של המסמך. האתר
genai.owasp.orgהחזיר קוד HTTP 403 בכל ניסיון גישה שנעשה לכתבה הזאת, ולכן שום דבר ממנו לא מצוטט ישירות, והוא לא מקושר כאן.
הגרסה הקצרה
חטיפת סוכני AI היא השם למצב שבו הטכניקה של prompt injection קורה במערכת שיכולה גם לפעול. המנגנון ישן ומובן היטב, אך ההשלכה חדשה. אף מסגרת לא כוללת טכניקה בשם הזה, כי הביטוי מתאר תוצאה ולא שיטה.
המספר שקיבלתם הוא רף תחתון. המדידה הממשלתית היחידה מצאה שההתקפה הקודמת החזקה ביותר הביסה את אותו סוכן ב-11% מהמקרים. ההתקפה החדשה והטובה יותר הביסה אותו ב-81% מהמקרים, באותה benchmark ובאותה מדידה. חזרה בלבד הזיזה מספר אחר מ-57% ל-80%. כל קצב הצלחת תקיפה שפורסם אומר לכם מה מישהו הצליח להשיג, לא מה אפשרי.
השלב הבא השימושי הוא לשאול שלוש שאלות על הפריסה שלכם, לא לרכוש משהו. מה הסוכן הזה קורא שאף אחד בצוות שלכם לא כתב? מה הוא יכול לעשות אחר כך? ומה גורם לו להתחיל? השאלה השלישית היא זאת שהמקורות מכסים ודפי ההסבר לא. הרשימה שיוצאת ממנה היא בדרך כלל הקצרה ביותר לכתיבה.