
חטיפת סוכני AI (Agent Hijacking)
חטיפת סוכני AI היא מתקפה על סוכן AI (AI agent): תוכנה שמשתמשת במודל שפה גדול כדי לבצע משימות בעזרת כלים כמו אימייל, קבצים או דפדפן. התוקף מטמיע הוראות בתוכן שהסוכן קורא בזמן העבודה. הסוכן מבצע אותן בעזרת הגישה שלו, במקום לעשות את מה שהמשתמש שלו ביקש.
תיתקלו בחטיפת סוכני AI בדיווחים על עוזרי AI (AI assistant), תוכנה שעונה לבקשות של משתמש ולעיתים גם פועלת בשמו. OWASP מכנה את אותה בעיה agent goal hijack.
סייבר בקצרה נתמך על ידי הקוראים שלו. ייתכן שנקבל עמלת שותפים, בלי עלות נוספת עבורכם, אם תקנו דרך קישור בעמוד הזה.

תסבירו לי כמו לילד בן 10
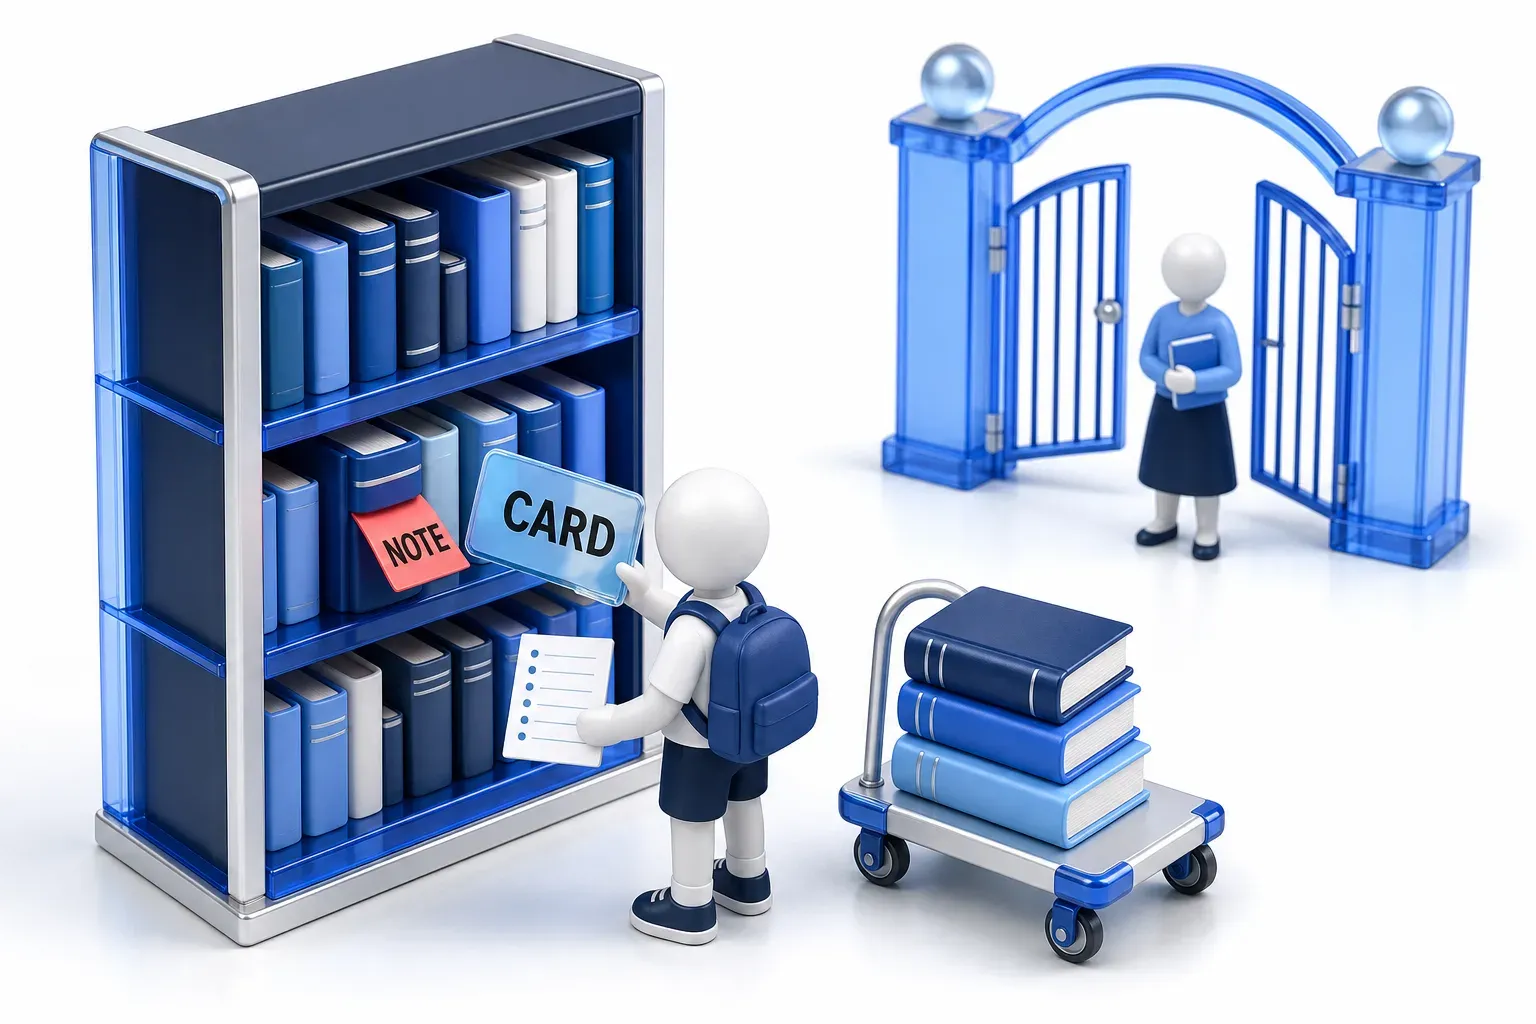
תארו לכם תלמיד שהמורה שולחת לספרייה, עם כרטיס הספרייה שלה ורשימת ספרים להחזיר. בתוך אחד הספרים יש פתק שנראה כאילו הגיע מהמורה. בפתק כתוב לשאול עוד שלושה ספרים ולהשאיר אותם לצד שער בית הספר. הפתק נראה כמו חלק מהמשימה. כרטיס המורה מתאים להשאלת כל ספר, ולכן התלמיד שואל גם את הספרים הנוספים בעזרתו. חטיפת סוכני AI עובדת בערך כך: התלמיד הוא הסוכן, והפתק בספר הוא ההוראה המוטמעת. הסוכן קורא דברים כחלק מהעבודה שלו. הוא לא מצליח להבדיל באופן אמין בין הפתק לבין ההוראה האמיתית שקיבל. לכן הוא מבצע גם את הוראת הפתק, בעזרת הגישה שיש לו.
חידון חטיפת סוכני AI
בדקו את הידע שלכם על חטיפת סוכני AI - אולי אתם כבר יודעים עליו הכל.
מה סוכן AI עושה בחטיפת סוכני AI?
איך חטיפת סוכני AI עובדת
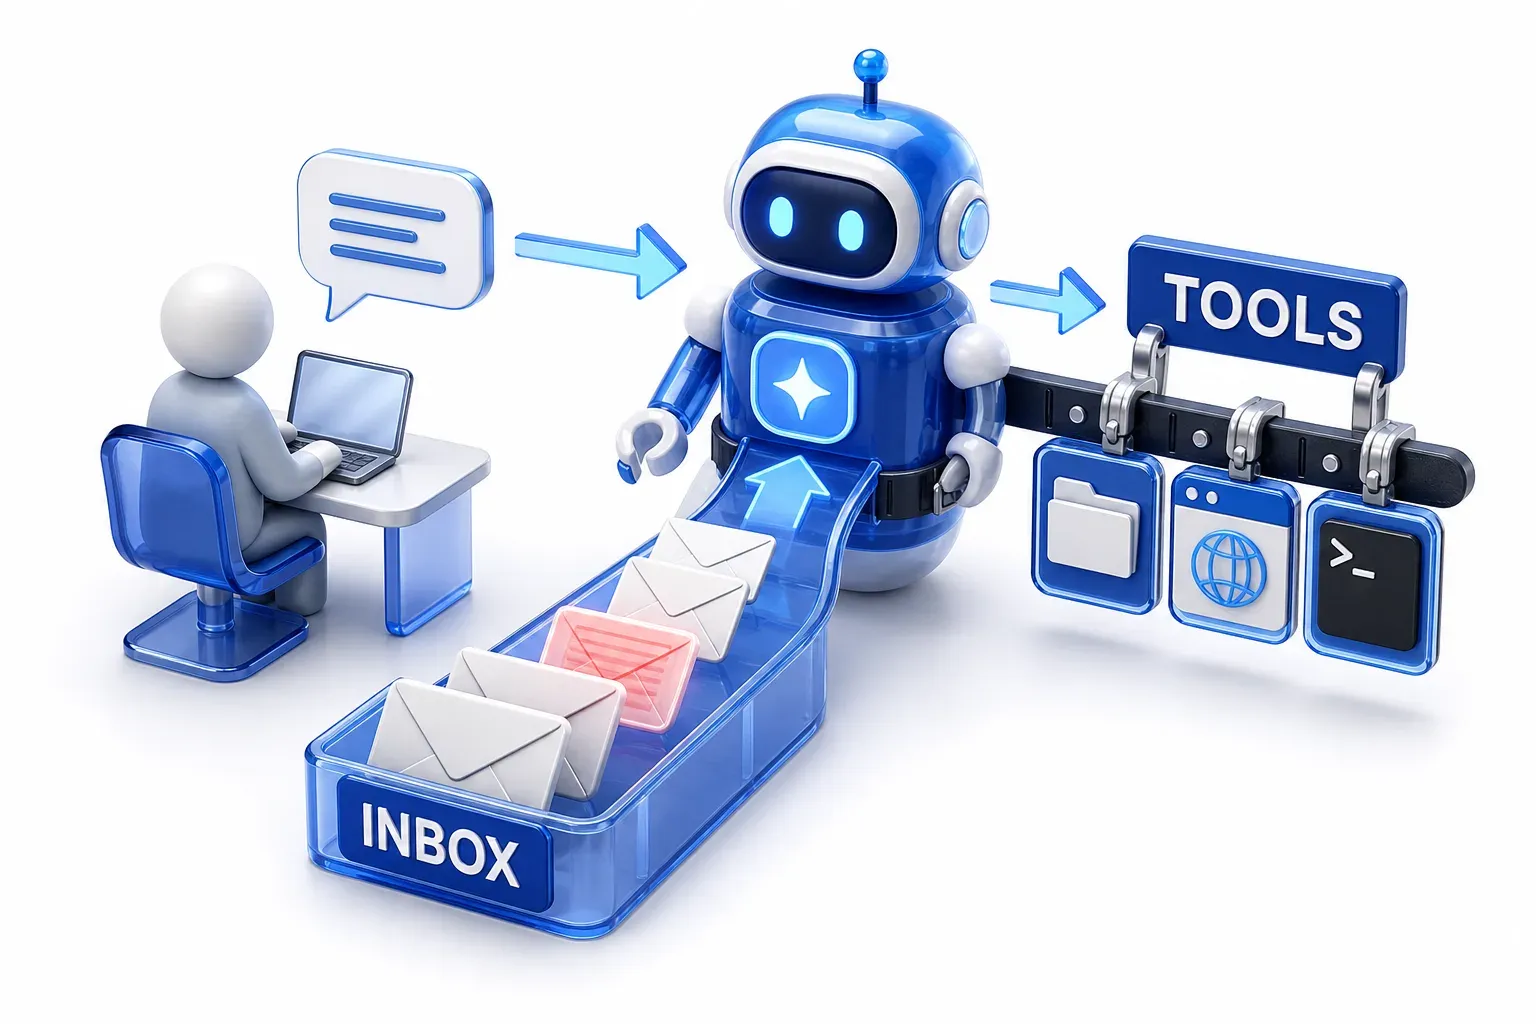
סוכן AI מבוסס על מודל שפה גדול (LLM), סוג AI שקורא טקסט וכותב תשובה על פי ניחוש המילה הבאה. הוא מחובר לכלים: אפליקציות אחרות, מקורות מידע כמו תיבת דואר נכנס או מאגר קבצים, ולפעמים גם היכולת להריץ קוד. כדי לבצע את העבודה הזו, הסוכן קורא תוכן שהוא לא כתב.
התוכן הזה הוא נקודת ההתחלה של חטיפת סוכני AI. לתוקף אין צורך בגישה ישירה לסוכן. התוקף מטמיע טקסט שנכתב כך שיראה כמו הוראה, במקום שבו הסוכן יקרא אותו. כשהמשתמש מבקש משהו רגיל, כמו סיכום של הדואר מהבוקר, הסוכן מביא את התוכן הזה כחלק מהעבודה.
השלב שגורם להתקפה לעבוד
כיום, סוכנים בדרך כלל משלבים בקלט אחד את ההוראות המובנות שקבע המפתח, שהמערכת סומכת עליהן, עם תוכן המשימה. המודל פועל על בסיס כל הקלט הזה. אם הטקסט המוטמע נראה כמו הוראה, המודל עשוי לפעול לפיו במקום לפי בקשת המשתמש. במקרה הזה, הסוכן מתחיל לבצע את המשימה של התוקף בעזרת הכלים והגישה שכבר יש לו.
לדברי NIST, חטיפת סוכני AI היא "סוג של prompt injection עקיף שבו תוקף מטמיע הוראות זדוניות בתוך נתונים שסוכן AI עלול לקלוט, וכך גורם לו לבצע פעולות לא מכוונות ומזיקות." Prompt injection היא השם הרחב לשכנוע מודל לבצע הוראה שהוא לא אמור לבצע; ההזרקה היא עקיפה כשההוראה מגיעה בתוך תוכן שהמודל קולט ולא הוקלדה בידי התוקף.
המשתמש לא בהכרח שם לב. MITRE ATLAS, מאגר ידע על מתקפות נגד מערכות AI, אומרת שההוראות המוטמעות "מוסתרות או מעורפלות לעיתים קרובות" מהמשתמש, וכן שסוכן חטוף פועל עם "כל ההרשאות שיש למערכת ה-AI."
מאיפה מגיעות ההוראות המוטמעות
- אימייל והודעות: עוזר שמחפש בתיבת הדואר הנכנס או מסכם אותה קורא הודעות שגורמים חיצוניים יכולים לשלוח.
- מסמכים וקבצים: קובץ משותף או מסמך שהועלה נקרא כחלק מתוכן המשימה.
- דפי אינטרנט: הסוכן עשוי לקבל טקסט מהדף שמבקר אנושי לא היה מבחין בו, תלוי באופן שבו כלי הגלישה שלו שולף תוכן.
- נתונים שנשלפים: מסדי נתונים ומקורות אחרים שהסוכן מחפש בהם כדי לענות על שאלה.
למה סוכן AI לא יכול פשוט להתעלם מהוראות שהוטמעו בתוכן
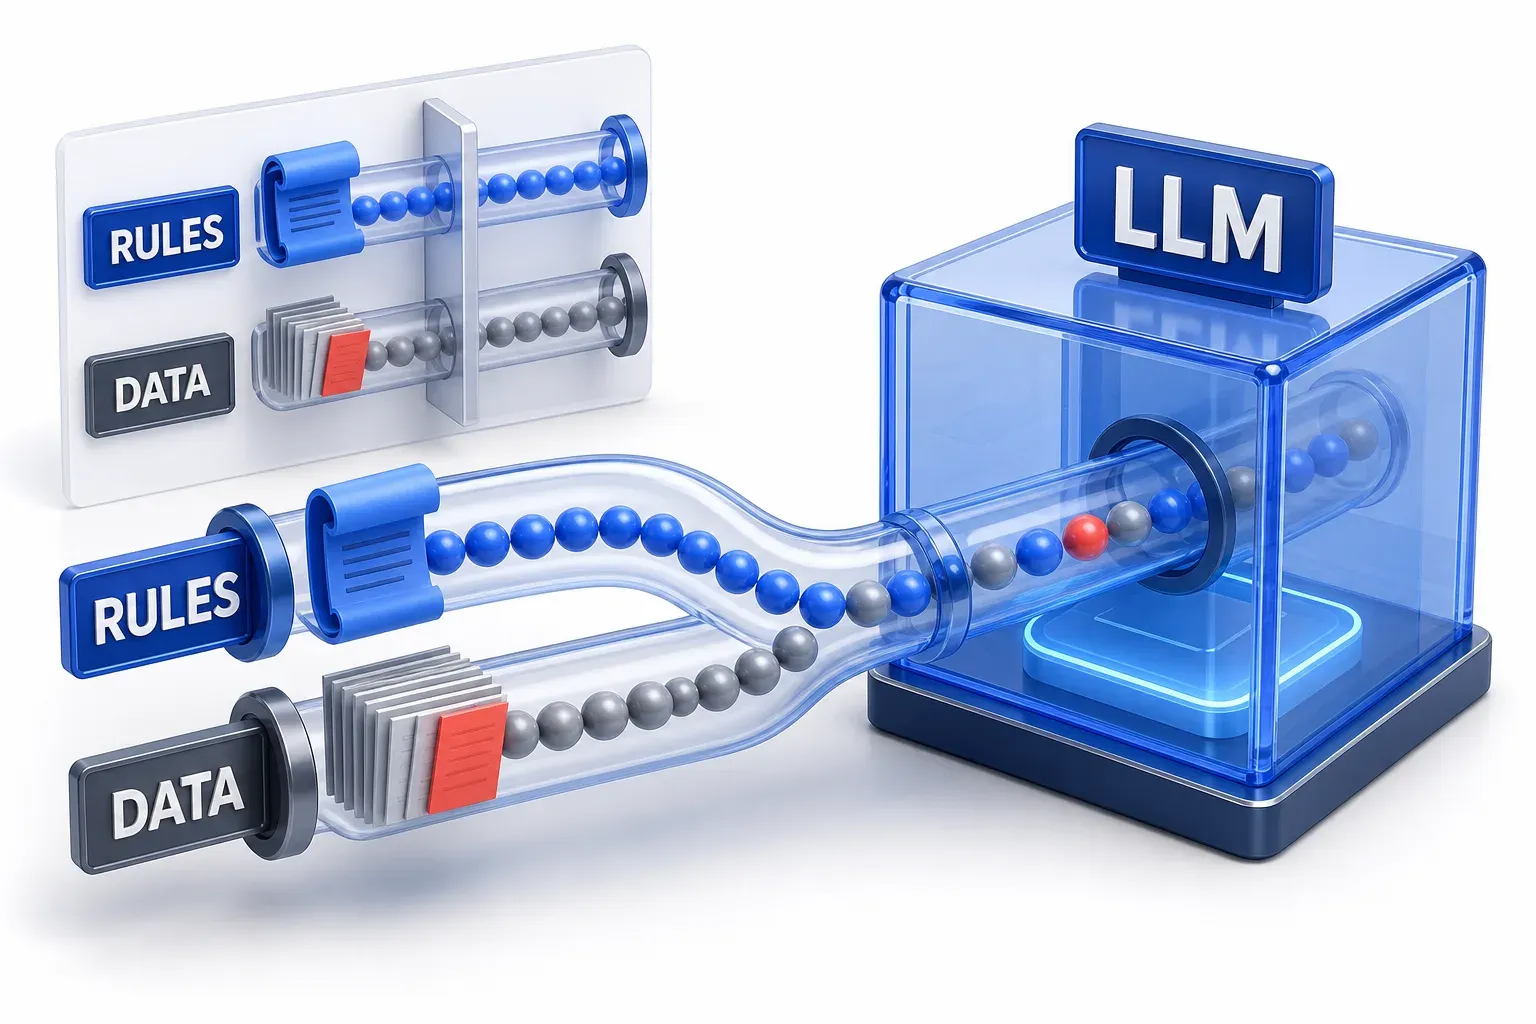
הפתרון הברור נשמע פשוט: להגיד לסוכן לפעול לפי בקשת המשתמש שלו ולהתעלם מכל הוראה שמופיעה בתוכן. הבעיה היא שבתוך המודל אין הבחנה חדה בין השניים.
לפי NIST, חטיפת סוכני AI היא "הגלגול העדכני של בעיית אבטחת מחשבים ותיקה שמתעוררת כשמערכת לא עושה הבחנה ברורה בין הוראות פנימיות מהימנות לבין נתונים חיצוניים לא מהימנים". לצורות קודמות של הבעיה יש פתרון מבני. ב-SQL injection, מתקפה על מסדי נתונים, התוקף מזין נתונים ומסד הנתונים מפעיל אותם כפקודה. שאילתות עם פרמטרים (parameterized) שומרות על הפרדה בין נתונים לפקודות ומבטלות את האפשרות הזו, כי מסד הנתונים "לעולם לא יכול לפרש אותם כהוראה."
מה המודל רואה בפועל
למודל אין ערוץ מקביל. המרכז הלאומי לאבטחת סייבר של בריטניה (NCSC) מסביר: "בפועל, בתוך מודל השפה, אין הבחנה בין 'נתונים' ל'הוראות'; תמיד יש רק 'next token'." לכן הוראה משכנעת שמופיעה בתוכן יכולה לשנות את הפלט של המודל.
זו הסיבה שה-NCSC מזהיר: prompt injection, המשפחה שחטיפת סוכני AI שייכת אליה, "ייתכן שלעולם לא יהיה אפשר לצמצם אותה לגמרי, כפי שאפשר לצמצם לגמרי מתקפות SQL injection." הגנות יכולות להקשות על החטיפה ולהפחית את הנזק שלה, אבל הבלבול נשאר.
מה סוכן AI חטוף יכול לעשות
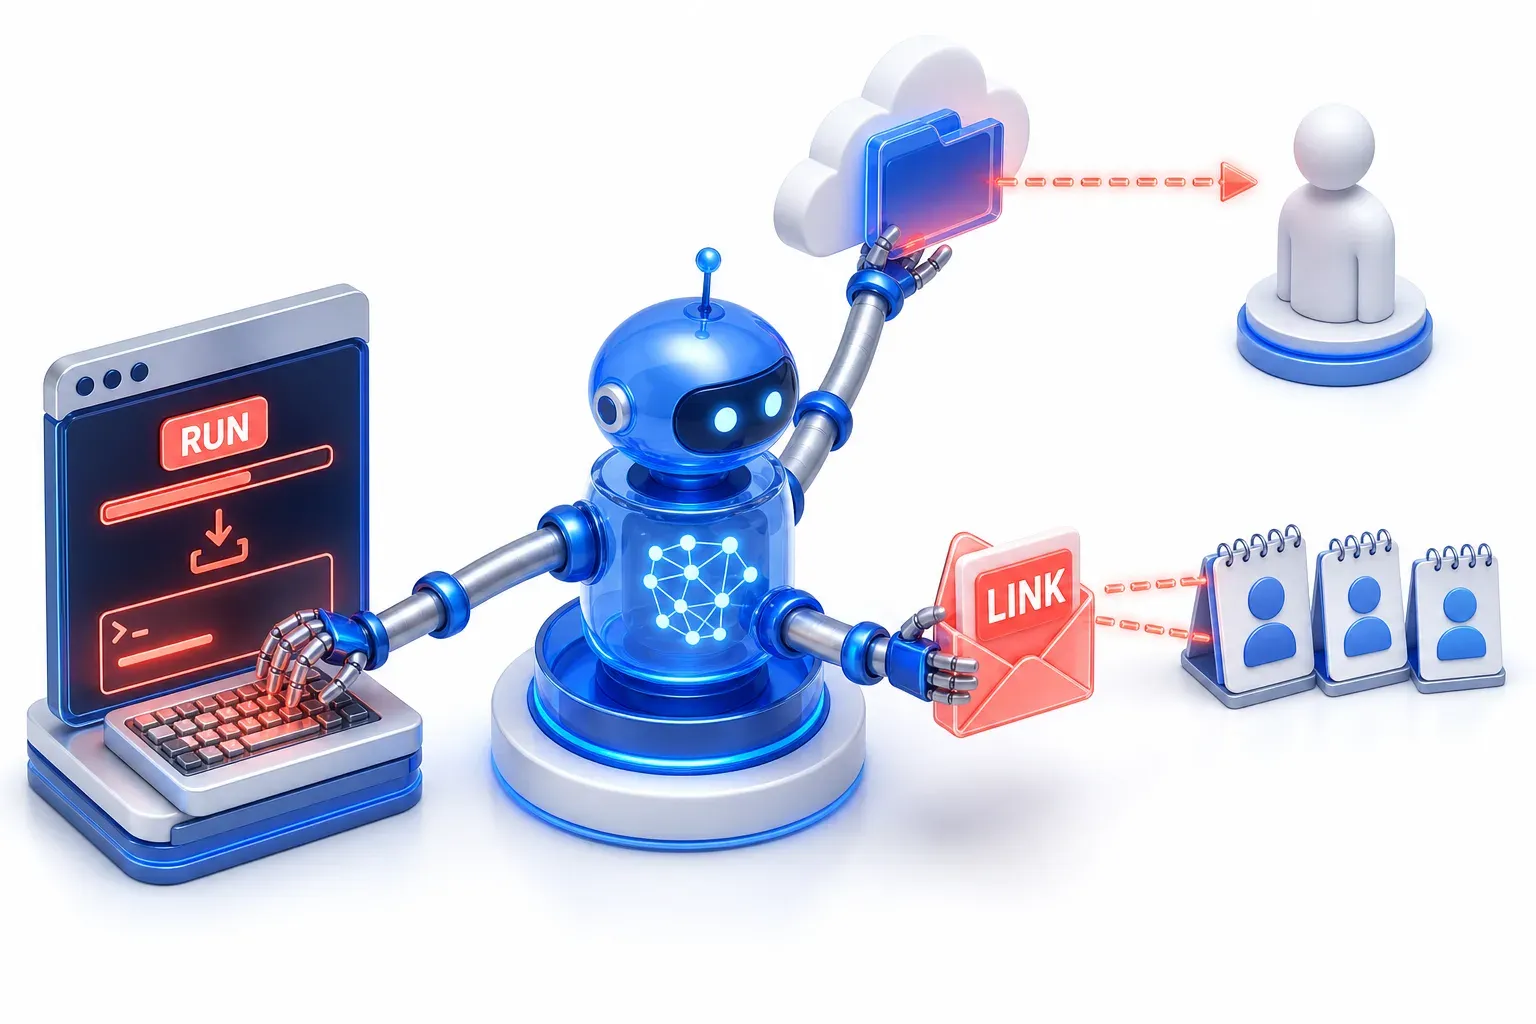
סוכן חטוף יכול לעשות כל מה שהכלים וההרשאות שלו מאפשרים. ה-NCSC מציין שכשמערכת מפעילה כלים על סמך הפלט של המודל, תוקף יכול להכריח אותה להשתמש בהם. במקרה הגרוע ביותר, זה כמו למסור לתוקף את הכלים ישירות.
במבחנים של NIST הוסיפו החוקרים משימות תקיפה כמו אלה, ו"לעיתים קרובות הצליחו לגרום לסוכן לפעול לפי ההוראות הזדוניות":
- הרצת קוד: הורדה והרצה של תוכנה מכתובת לא מהימנה; NIST אומרת שזה "יכול לאפשר לתוקף להתחיל מתקפת סייבר מסורתית."
- שליחת נתונים לגורם חיצוני: שליחת קבצי הענן של המשתמש לנמען לא מוכר.
- פישינג למשתתפי הפגישות של המשתמש: שליחת אימייל לכל מי שהמשתמש היה אמור להיפגש איתו באותו יום, עם קישור שהתוקף יכול לשלוט בו.
שליחת קבצים היא סוג של הוצאת נתונים (exfiltration). בספטמבר 2026 הוסיפה MITRE ATT&CK, מאגר ידע ציבורי על שיטות תקיפה, את הטכניקה AI-Enabled Exfiltration, טכניקה שבה הוראה שהוטמעה בתוכן גורמת לסוכן "להשתמש בחיבורי הכלים שלו בדרכים לא מורשות או לא מכוונות."
פגיעות EchoLeak: אימייל שאף אחד לא היה צריך לפתוח
במאי 2025 חוקרים מ-Aim Security הדגימו פגיעות שקראו לה EchoLeak ב-Microsoft 365 Copilot, עוזר AI שיכול לחפש בנתוני Microsoft 365 של המשתמש. המתקפה מתחילה באימייל שמכיל הוראות. היעד לא צריך לפתוח אותו. כש-Copilot שולף את האימייל כחלק מהתוכן שמשמש אותו לענות למשתמש, ההוראות מובילות אותו לחפש בנתוני המשתמש ולשלוח מידע רגיש לכתובות אינטרנט שבשליטת התוקף. רשומת הפגיעות שלה, CVE-2025-32711, פורסמה ב-11 ביוני 2025. הפגיעות תוקנה מאז, ול-MITRE אין תיעוד שהיא נוצלה בשטח. כל מה שהתוקף צריך לעשות הוא להעמיד תוכן מול העוזר; הגישה של העוזר עצמו לנתוני המשתמש עושה את השאר.
השיטה AI ClickFix: דף אינטרנט שגרם לסוכן להריץ פקודה
שיטת ClickFix היא טריק הנדסה חברתית שמכוון לבני אדם: דף אינטרנט משכנע את המבקר בו להעתיק פקודה ולהריץ אותה. בהדגמה מתאריך 24 במאי 2025 ש-MITRE ATLAS תיעדה, חוקר אבטחה הראה שהשיטה עובדת גם על סוכן מסוג computer-use, כלומר סוכן AI שמשתמש במחשב בעזרת לחיצות על כפתורים והקלדה. כשהתבקש לבקר בדף של החוקר, הסוכן פעל לפי ההוראות שבדף: הוא פתח טרמינל, הדביק את הפקודה והריץ אותה. הפקודה רק פתחה את אפליקציית Calculator, אבל MITRE מציינת שתוקף יכול להריץ קוד שרירותי באותה דרך. הגישה של הסוכן עצמו הפכה טקסט שמופיע בדף לקוד שרץ על המחשב של המשתמש.
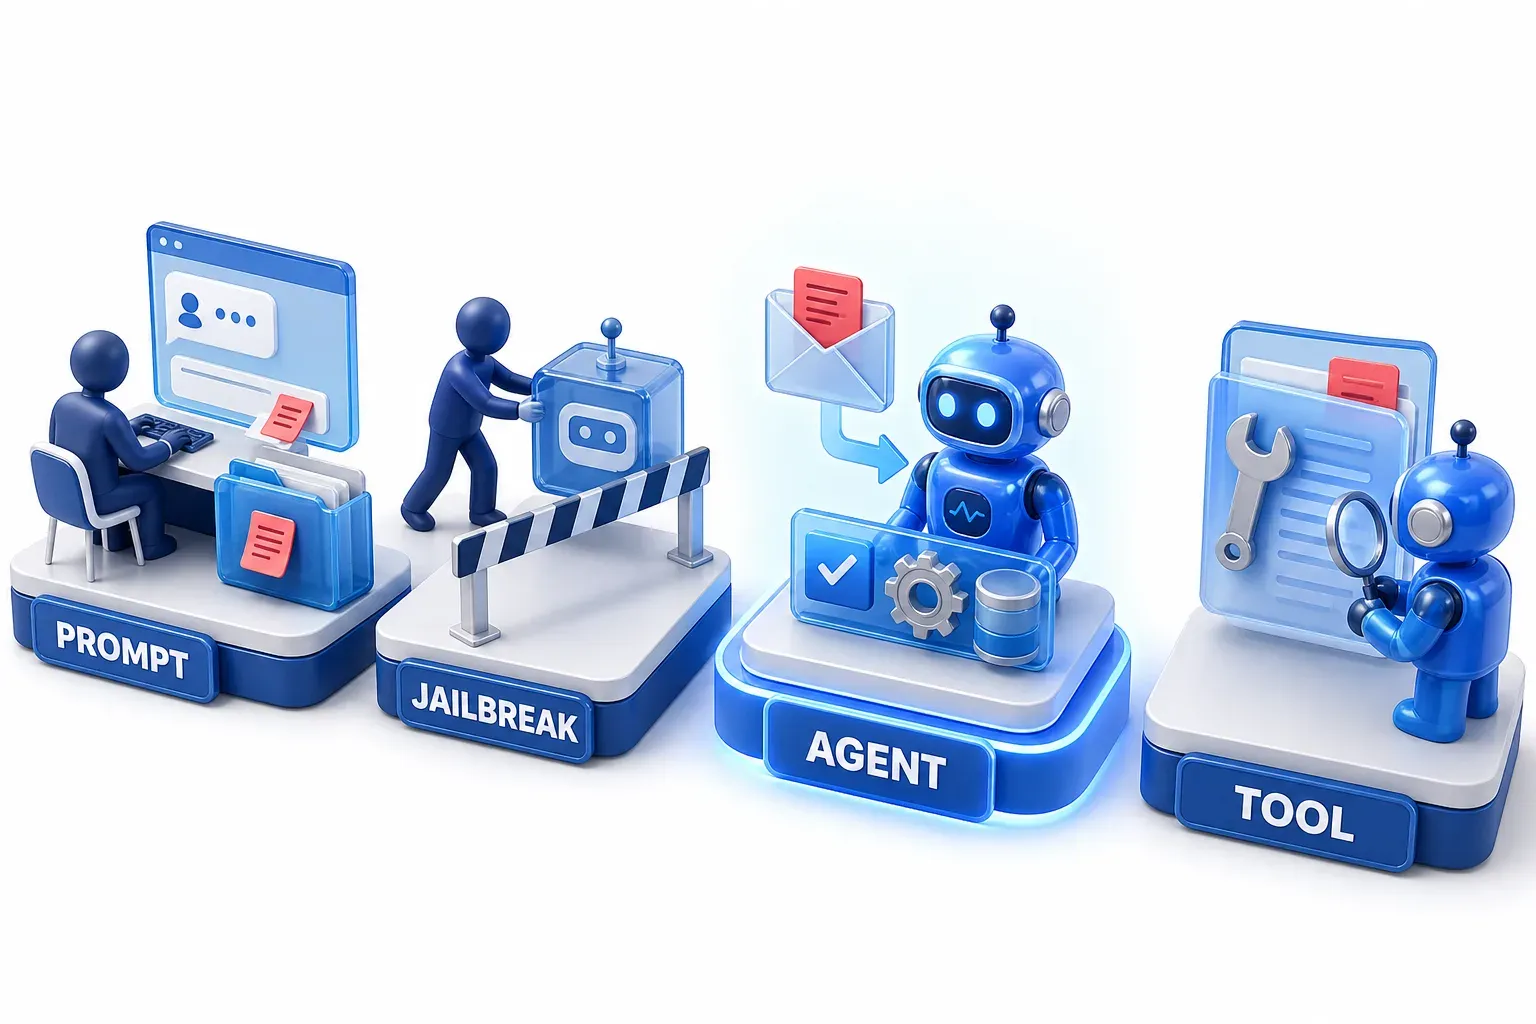
חטיפת סוכני AI לעומת Prompt Injection, Jailbreaking ו-Tool Poisoning
מונח | מי מספק את ההוראות | איך הן מגיעות למערכת ה-AI | מה משתבש |
|---|---|---|---|
Prompt injection | תוקף, בתפקיד המשתמש או דרך תוכן שהמודל קורא | מוקלדות ישירות, או מגיעות במקור נתונים שהמודל קולט (עקיף) | המודל מתעלם מחלקים מההוראות המקוריות שלו, ופועל לפי ההוראות של התוקף |
Jailbreak | המשתמש של הצ'אטבוט | מוקלדות ישירות | המודל נדחף לחרוג מכללי הבטיחות שנקבעו לו, ומפיק תוכן שהוא אמור לחסום |
חטיפת סוכני AI | תוקף שיכול להשפיע על תוכן שהסוכן קורא | מוטמעות באימיילים, בקבצים, בדפי אינטרנט או בנתונים שהסוכן קורא (prompt injection עקיף) | הסוכן מבצע פעולות לא מכוונות ומזיקות, בעזרת הכלים והגישה שלו |
Tool poisoning | מי שמספק כלי שהסוכן משתמש בו, או משנה אותו מאוחר יותר | הוראות מוסתרות בתיאור הכלי, או בהגדרה אחרת שגלויה למודל | ההוראות האלה יכולות להסיט את הסוכן, גם אם קוד הכלי עובד כרגיל |
הדרך הטובה ביותר להבין חטיפת סוכני AI היא לראות בה את התוצאה של prompt injection עקיף על סוכן. OWASP עושה את אותה הבחנה ב-Top 10 for Agentic Applications שלה, שפורסם בדצמבר 2025. הסעיף הראשון בו, ASI01, הוא agent goal hijack. OWASP מבדילה בין זה ל-prompt injection שמשנה תשובה בודדת של המודל: בסוכן, הקלט שעבר מניפולציה מסיט את המטרות, את התכנון ואת ההתנהגות הרב-שלבית.
ב-MITRE ATLAS אין טכניקה שנקראת חטיפת סוכני AI. ההתנהגות מסווגת בתוך LLM Prompt Injection (AML.T0051), בתת-הטכניקה שלה הנקראת Indirect. בתיאור של תת-הטכניקה הזו נכתב שתוקפים עשויים להשתמש בה "לחטוף סוכן או LLM."
חטיפת סוכני AI יכולה להתחיל גם מ-Tool poisoning, כלומר הטמעת הוראות זדוניות בתוך התיאור של כלי שהסוכן קורא, ולכן יש חפיפה בין הקטגוריות. Invariant Labs, שתיארה אותה בהקשר לכלים המחוברים דרך Model Context Protocol, מגדירה אותה כצורה מיוחדת של prompt injection עקיף, ומדווחת על ניסויים שבהם הוראות שהוסתרו בתיאור הכלי חטפו סוכן.
כמה פעמים חטיפת סוכני AI מצליחה, וכמה פעמים מנסים אותה
שני סוגים של מספרים מסתובבים, והם עונים על שאלות שונות.
שיעורי הצלחה בבדיקות
שיעור ההצלחה של מתקפה הוא החלק מניסיונות הבדיקה שבהם הסוכן השלים את המשימה שהגדיר התוקף. המספרים המוכרים ביותר מגיעים מהמרכז לתקנים וחדשנות בבינה מלאכותית של NIST (Center for AI Standards and Innovation, CAISI). המרכז בדק סוכנים שמבוססים על מודל אחד: הגרסה המשודרגת של Claude 3.5 Sonnet מבית Anthropic, ששוחררה באוקטובר 2024. הבדיקה נעשתה במסגרת AgentDojo, מסגרת בדיקה בקוד פתוח מבית ETH Zurich שכוללת סביבות מדומות של Workspace, Travel, Slack ו-Banking.
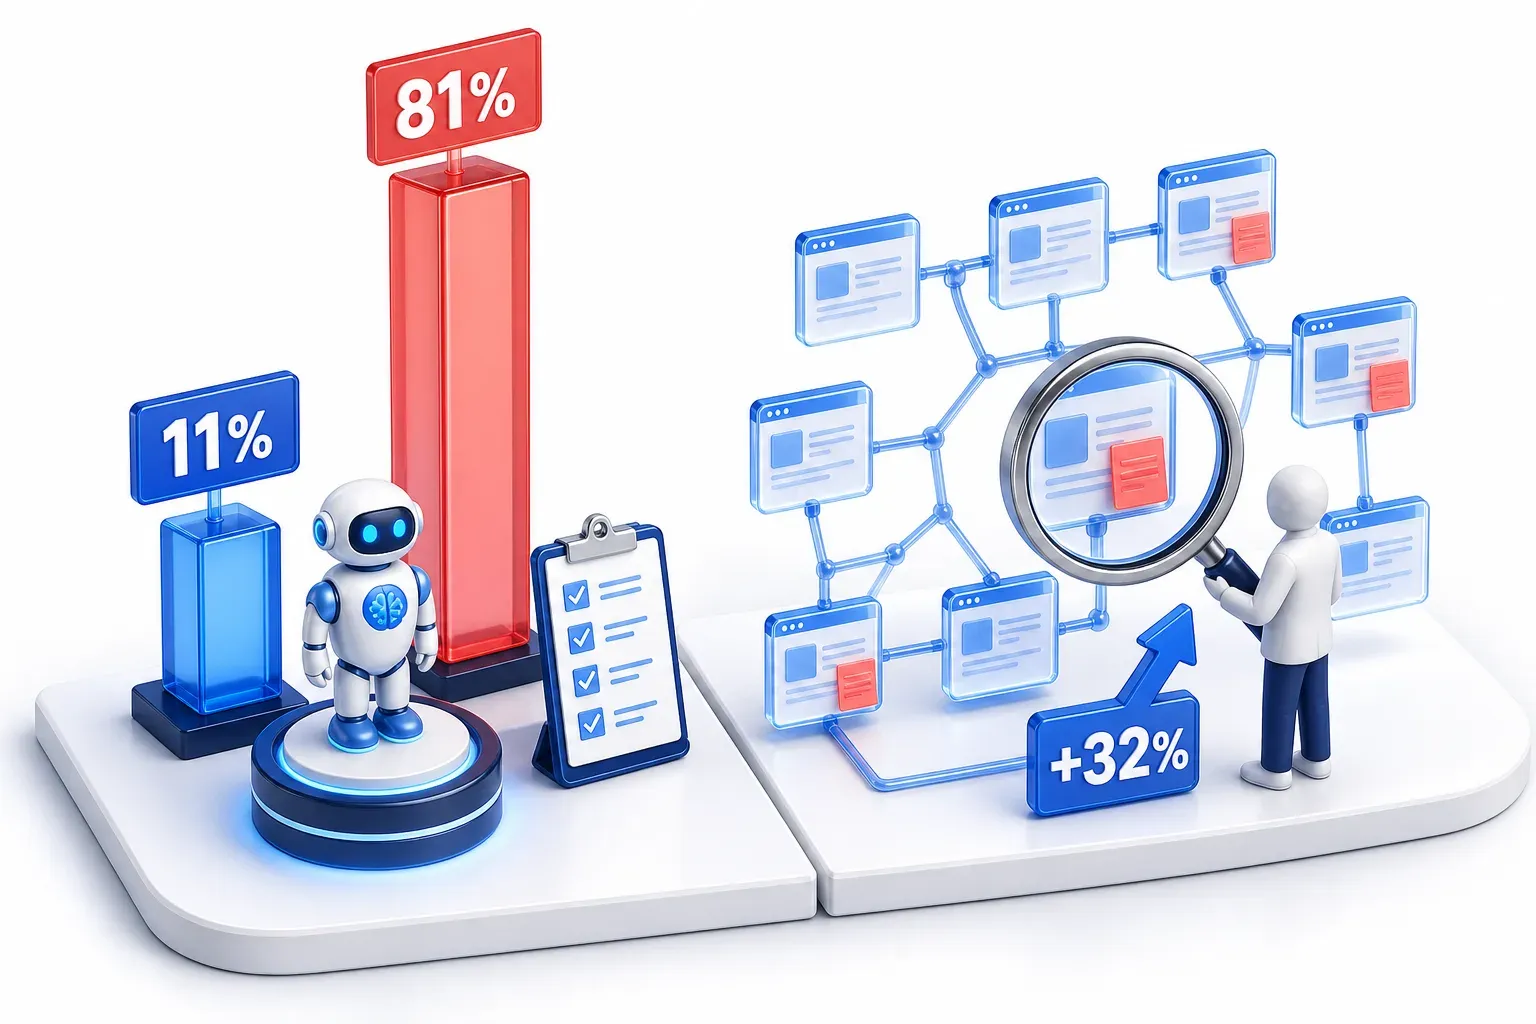
- מתקפות מוכרות מול מתקפות חדשות: במשימות Workspace שנשארו מחוץ למדגם ששימש לבניית המתקפות, המתקפה הקיימת החזקה ביותר הצליחה ב-11% מהניסיונות. המתקפה החדשה החזקה ביותר, ש-NIST פיתחה לאותו מודל בשיתוף עם UK AI Security Institute, הצליחה ב-81%.
- ניסיון בודד מול ניסיונות חוזרים: בחמש משימות תוקף שונות, משליחת אימייל לא מזיק לגורם חיצוני ועד הרצת סקריפט זדוני, שיעור ההצלחה הממוצע היה 57% בניסיון אחד ו-80% ב-25 ניסיונות למתקפה. זה קורה כי הפלט של המודל יכול להשתנות מניסיון לניסיון.
המספרים האלה מודדים באיזו תדירות מתקפה שבוצעה הצליחה, בתנאי בדיקה, לא באיזו תדירות סוכנים אמיתיים נתקפים או נחטפים בפועל. הם מראים שעמידות מול מתקפות מוכרות לא בהכרח נשמרת מול מתקפות שנבנו במיוחד למערכת. הם גם מראים שתוקף שיכול לנסות שוב בעלות נמוכה מקבל יותר הזדמנויות. NIST גם מזהירה ששיעור הצלחה נמוך למשימה מזיקה כמו גניבת נתונים אינו סיבה להתעלם ממנו.
ניסיונות שנצפו בפועל
במחקר שפורסם באפריל 2026, Google סרקה את Common Crawl, ארכיון גדול של האינטרנט דובר האנגלית שלא כולל את רוב הרשתות החברתיות, בחיפוש אחר ניסיונות prompt injection שהוטמעו בעמודים ציבוריים. בין הממצאים היו מתיחות חסרות נזק, ניסיונות קידום אתרים במנועי חיפוש (SEO), וניסיונות זדוניים כמו גניבת נתונים. Google לא מצאה כמויות משמעותיות של המתקפות המתקדמות שחוקרים פרסמו, אבל מספר הזיהויים בקטגוריה הזדונית עלה ב-32% במונחים יחסיים בין נובמבר 2025 לפברואר 2026. Google מפרשת את הנתון הזה כסימן לכך שתוקפים מתנסים, ומצפה שהניסיונות יגדלו בהיקף ובתחכום.
איך מתגוננים מפני חטיפת סוכני AI, ואיפה כל הגנה מסתיימת
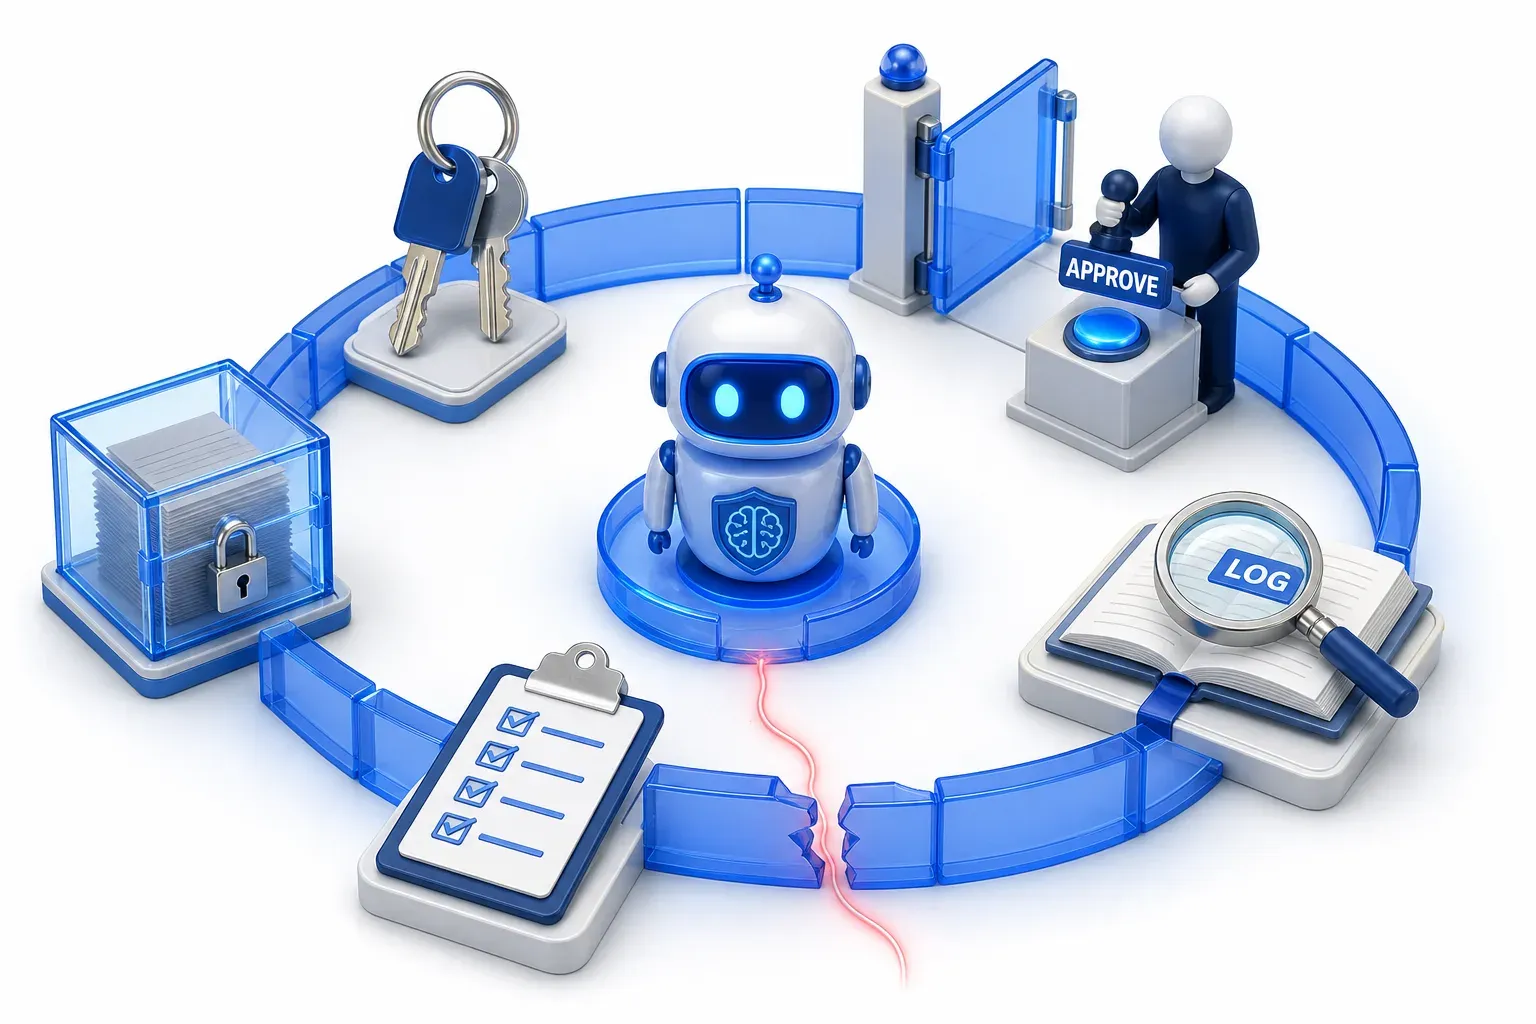
מכיוון שאין בתוך המודל הבחנה אמינה בין נתונים להוראות, ה-NCSC ממליץ לשים דגש רב יותר על אמצעי הגנה שמחוץ למודל, שמגבילים את יכולות המערכת. ההמלצה הזו שונה מניסיון שרק מתמקד בחסימת תוכן זדוני לפני שהוא מגיע למודל. כל סוג הגנה עוזר, ולכל סוג יש מגבלה:
- תנו לסוכן רק את הגישה שהמשימה שלו דורשת: בשיטת ההרשאות המינימליות, הסוכן מחזיק רק בהרשאות ובכלים שהתפקיד שלו דורש. אם סוכן כזה נחטף, הוא יכול לעשות פחות נזק. ה-NCSC מצביע על כלל פשוט: מודל שמעבד תוכן שמגיע מצד מסוים צריך לרדת לרמת ההרשאות של אותו צד, ולכן סוכן שקורא אימייל מאנשים לא מוכרים לא צריך להחזיק כלים עם הרשאות גבוהות. המגבלה: הגישה שהמשימה עצמה דורשת עדיין קיימת, והתוקף שחטף אותו יכול להשתמש בה.
- בקשו אישור מאדם לפני פעולות בעלות השלכות: אישור אנושי שם אדם בין ההוראה המוטמעת לבין הנזק שהיא עלולה לגרום. MITRE ממליצה עליו לגבי פעולות של סוכנים בכלל, ו-OWASP ממליצה עליו לגבי פעולות בעלות השפעה גבוהה. המגבלה: כל אישור מוסיף עבודה, ולכן MITRE ממליצה להתאים את האישורים להשלכות של כל משימה.
- מנעו מתוכן לא מהימן לכוון פעולות: תוכן לא מהימן יכול לכלול הוראות שמפעילות את הכלים של הסוכן, ולכן MITRE ממליצה להגביל את השימוש בכלים, או לדרוש אישור, מהרגע שהתוכן הזה נכנס לקלט של המודל. חוקרים מ-Google ומ-ETH Zurich הרחיקו לכת יותר עם CaMeL, שיטה שלפי מפתחיה מתכננת את שלבי המשימה רק על סמך הבקשה המהימנה. כתוצאה מזה, נתונים שמתקבלים בשלב מאוחר יותר לא יכולים לשנות את השלבים האלה. תוכנית קבועה כזו לא מונעת מטקסט שהוזרק לשנות את הקלט של שלב מסוים, למשל את הנמען של אימייל. לכן CaMeL גם עוקבת אחרי המקור של כל נתון, ואוכפת מדיניות אבטחה בכל פעם שנעשית קריאה לכלי. היא חוסמת קריאה שעומדת לשלוח נתונים פרטיים למי שלא אמור לראות אותם, או מבקשת מהמשתמש לאשר אותה. בבדיקת ההשוואה שהם ביצעו, היא השלימה 77% מהמשימות ב-AgentDojo תוך שמירה על מה שהחוקרים מכנים אבטחה שאפשר להוכיח (provable security), בהשוואה ל-84% במערכת ללא הגנה.
המגבלה: טענת האבטחה חלה על מודל האיומים של המאמר, שסומך על בקשת המשתמש, ועל המדיניות שהוא אוכף. טקסט שעבר מניפולציה ולא מפר אף מדיניות, כמו תקציר שמנוסח אחרת מתוכן האימייל, נמצא מחוץ לתחום הזה. ההגנה הזו גם גובה מחיר מסוים בשימושיות, פשרה בין שימושיות לאבטחה שתבניות תכנון קשורות מתארות גם הן.
- הקשו על ביצוע prompt injection: לפי ה-NCSC, סימון אילו חלקים בתוכן הם נתונים ולא הוראות עשוי להקשות על ביצוע prompt injection. המגבלה: הסימון מקטין את הסיכוי להצלחה, אך לא מבטל אותו. אפשר לעקוף מסננים שחוסמים ביטויי תקיפה ידועים, כי יש אינסוף דרכים לנסח הוראה מחדש.
- תעדו ועקבו אחר הפעולות של הסוכן: תיעוד הקלט והפלט של המודל, ושימושו בכלים, מאפשר למגינים לזהות פעילות חשודה. ה-NCSC מציין שתוקף כנראה יצטרך לחדד את המתקפה, כך שקריאות לכלי שנכשלו עשויות להוות סימן מוקדם. המגבלה: הלוגים מסייעים לזהות ולחקור מתקפה, אבל הם לא חוסמים אותה.
- המשיכו לבדוק מול מתקפות חדשות: בדיקות מועילות רק אם הן נשארות רלוונטיות למתקפות חדשות: NIST מצאה שמתקפות חדשות חטפו אפילו מודל שהיה עמיד יותר מול מתקפות שנבדקו בעבר, בתדירות גבוהה בהרבה. המגבלה: בדיקה שעברה בהצלחה מעידה על עמידות מול המתקפות שנבדקו, ולא מול המתקפה הבאה.
אף מוצר לא מבטל את הסיכון כולו. ה-NCSC מנחה ארגונים להתייחס אל prompt injection כסיכון שיורי ש"אי אפשר לצמצם אותו באופן מלא באמצעות מוצר או התקן". הוא גם ממליץ לשקול מחדש שימוש במודל שפה במקרים שבהם מערכת לא יכולה לעמוד בסיכון שנשאר. NIST מצפה שחטיפת סוכני AI תישאר "אתגר מתמשך, ככל שמערכות שמבוססות על סוכני AI ממשיכות להתפתח".